
模糊测试(Fuzz Testing)入门指南
什么是模糊测试?本文讲解 Fuzz Testing 的原理、输入生成与覆盖率反馈、常用工具及如何把 fuzzing 接入日常测试流程,发现常规测试覆盖不到的缺陷。
本文依据官方文档整理,未执行运行验证或性能基准。代码片段展示局部用法,业务函数、数据和环境需按项目补齐;版本与配置以所引文档为准。
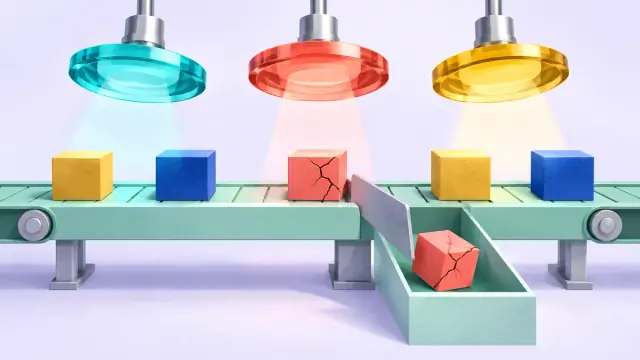
直接回答:模糊测试(Fuzz Testing)是一种自动化测试技术,向程序大量投喂随机、畸形或边界输入,观察它是否崩溃、卡死或产生异常行为,从而发现手工用例很难想到的缺陷和安全漏洞。 它的价值不在替代常规测试,而在补充——单元测试验证"已知的行为",模糊测试探索"未知的边界"。
模糊测试的由来
模糊测试最早可以追溯到 1980 年代末威斯康星大学的 Barton Miller 教授的一次课堂实验:让学生在 Unix 命令行工具上输入随机字符串,发现随机输入能触发一些工具崩溃或挂起。这个看似"暴力"的方法从此发展成一个严肃的测试分支,如今在浏览器、操作系统、解析库的安全性验证中被广泛使用。
两个分类维度
| 模式 | 原理 | 特点 |
|---|---|---|
| 变异式(Mutation-based) | 以已有合法输入为种子,随机翻转、截断、拼接生成新输入 | 实现简单,不需要理解协议,但容易生成大量无效输入 |
| 覆盖率引导式(Coverage-guided) | 实时监控代码覆盖率,优先保留能触发新路径的输入 | 效率高,能深入探索代码分支,libFuzzer、AFL++ 都走这条路 |
| 生成式(Generation-based) | 按协议/格式规范生成结构化输入,再做受控变异 | 适合解析器、协议实现,能保证输入"大体合法、局部异常" |
变异式与生成式描述输入如何产生;覆盖率引导描述如何使用反馈选择输入,两者并不互斥。工具可以同时采用变异生成与覆盖率反馈。
典型工作流
- 选定目标:优先 fuzz 解析外部输入的代码——文件解析、协议处理、反序列化、正则引擎。
- 编写 fuzz 入口:一个接收字节流的函数,内部调用被测逻辑,不得吞掉崩溃。
- 跑起来:工具会持续生成输入并记录触发崩溃的样本。
- 分析崩溃:去重、最小化复现样本,定位根因。
- 回归固化:把每个历史崩溃样本加入语料库,防止回归。
以 Go 原生 fuzzing 为例:
func FuzzParseConfig(f *testing.F) {
    f.Add("key=value")
    f.Fuzz(func(t *testing.T, data string) {
        cfg, err := ParseConfig(data)
        if err != nil {
            return // 返回错误是允许的
        }
        // 健壮性检查:解析成功后的序列化不应 panic
        _ = cfg.String()
    })
}
Go 1.18+ 在已有 ParseConfig 实现的包中执行 go test -fuzz=FuzzParseConfig -fuzztime=60s。示例只检查成功解析后的 String 不崩溃,并没有断言完整往返一致性。仅对有授权的本地目标运行,限制 CPU、内存、时间和输出,避免命中生产数据及外部付费接口。
接入日常流程的建议
- CI 里定时跑:模糊测试天然耗时,适合夜间任务或独立流水线,跑 30~60 分钟一轮。
- 崩溃即工单:每次发现新崩溃都应建 issue 跟踪,修复后样本进语料库。
- 和单元测试互补:fuzz 发现的边界 case,修复后顺手补一个常规单元测试。
- 关注资源消耗:除崩溃外,内存爆炸、CPU 死循环同样是 fuzzing 的重要产出。
常见问题(FAQ)
Q:模糊测试能替代单元测试吗?
A:不能。两者目标不同:单元测试验证预期行为是否正确,模糊测试探索非预期输入下程序是否健壮。最佳实践是互补使用。
Q:Fuzzing 跑多久才算够?
A:没有标准答案。实践中以"连续一段时间不再发现新路径/新崩溃"为收敛信号;CI 中一般每轮 30 分钟到数小时,配合语料库持续累积。
Q:发现崩溃后第一步做什么?
A:先最小化复现样本(多数工具自带 minimize 功能),确认是真实缺陷而非测试环境问题,再定位根因。
官方参考
资料核对日期:2026-09-29。
